这些年参与过一些智慧水务项目的评审和问题诊断,发现一个让人痛心的“轮回”:企业花大价钱上了很多系统——SCADA、GIS、营收、DMA、二次供水管理、模型…… 可每到需要快速决策,比如暴雨内涝时泵站如何联动、爆管后如何精确关阀并通知受影响用户,大家还是打电话、看静态表格、凭经验。
原因并不复杂:看似各个系统都在线,其实是一堆“烟囱群”,而智慧水务真正的地基——数据底座,从一开始就缺位了。
一、为什么“烟囱群”是智慧水务最大的坑
所谓“烟囱群”,是指为满足单一业务需求竖立起来的一个个独立IT系统。它们有自己的数据库、自己的逻辑、自己的界面,彼此之间老死不相往来。
在早期,这没问题。
调度室想看压力流量,上个SCADA;
管网部要管阀门和管道属性,上个GIS;
营业所要查水费,上个营收系统。
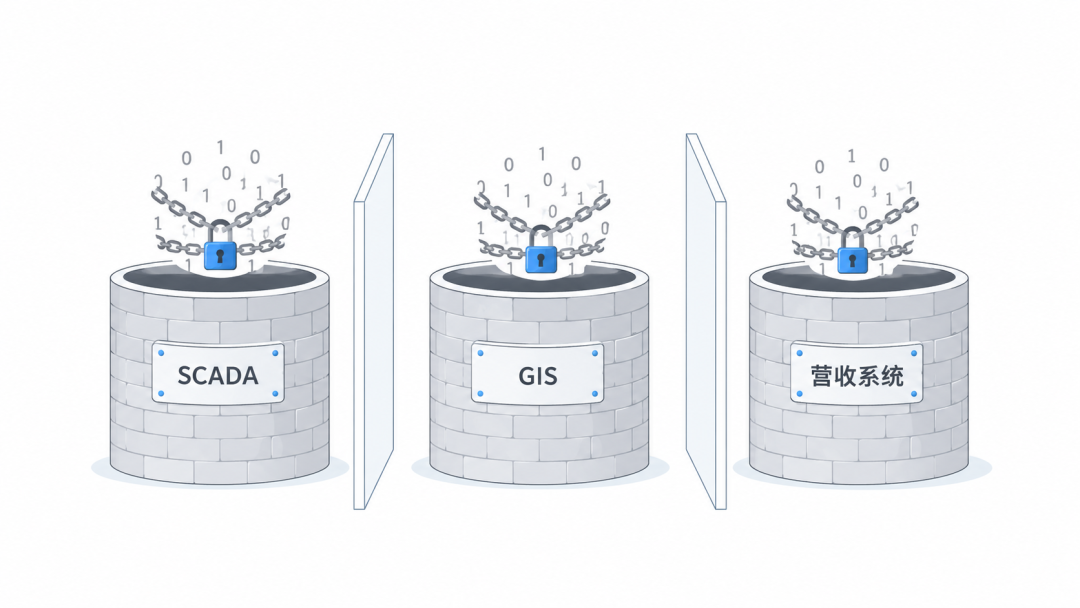
但一旦我们要走向“智慧”,想让数据驱动决策,这些烟囱就会变成巨大的障碍。
最典型的痛点是 “数据三问” :
一问:管网里某个压力点突变,到底是阀门操作、泵站调整还是爆管引起的?需要同时看SCADA数据、GIS拓扑、营收区域、维修工单,而这些分属四个系统,时间戳和编码规则都不同。
二问:一个区域的漏损率上升,能否联动实时的DMA分区的夜间最小流量、管网老化程度以及当前的地面施工信息?通常,这些数据沉睡在不同部门的Excel里。
三问:一个泵站的能耗异常,对应的是哪个时段的供水调度策略?调度指令、电表数据和水泵运行曲线常常三张皮。
烟囱式的架构,导致数据被锁在业务部门的“信息孤岛”里。我们得到的不是全局的洞察,而是一堆散落的、口径不一的报告。试图在此之上强行搭建“智慧大脑”,就像在沼泽上盖高楼——投入越大,隐患越多,最后“大屏”成了遮羞布,看起来什么都有,实际没有一个数据能真正联动起来做实时分析。这是智慧水务最大的坑。
二、数据底座到底是什么:让数据“活起来、跑起来、用起来”
很多同行问我,数据底座是不是一个更强大的数据库?或者就是现在流行的数据中台?再不就是那块炫酷的大屏?
都不是。
数据库只是被动的数据容器,它不负责数据是否鲜活、是否可理解、是否按业务逻辑串联。
数据中台在很多实践中容易沦为另一个更大的烟囱——汇聚了数据,但如果缺乏与业务实时联动的治理和服务机制,最终会成为僵死的“数据沼泽”。
大屏更是最表层的呈现,它只是数据的“最后一公里”,如果后面的路不通,大屏不过是静态图表的展示器。
数据底座,是一个让数据“活起来、跑起来、用起来”的系统工程。 它不是一个产品,而是一套分层解耦、持续运转的机制。它的核心使命,是把水务企业散落在各处、异构、脏乱的数据,变成可信任、可理解、可实时调用的统一服务。
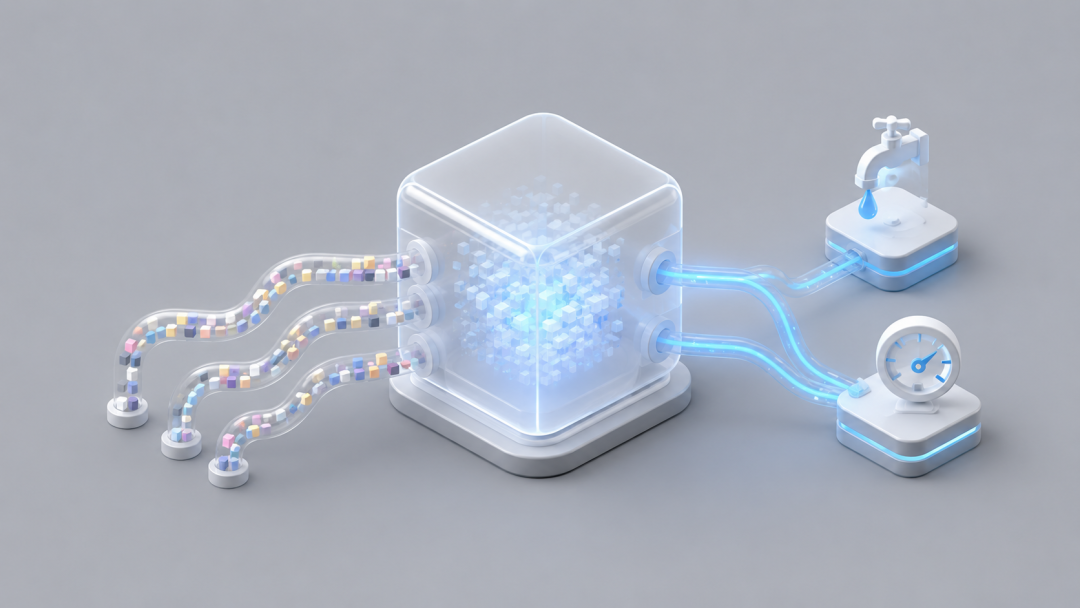
活起来:每个压力变送器、电磁流量计、水质探头的每一次跳动,每一项工单、每一个用户投诉,都从源头被实时、准确地捕获,不再是滞后的人工录入和抽检。
跑起来:数据跨部门、跨系统、跨主题地自动融合,统一时空基准和对象编码。一个阀门ID,在资产系统、GIS、SCADA、模型中代表同一个物理实体,且能根据拓扑关系自动追溯其影响范围。
用起来:业务人员可以像调用水电一样,通过标准化的接口随时随地获取高质量的数据服务,进行即时分析、模型计算和决策推送,而不是等信息中心提数、再手工Excel加工。
三、数据底座的四层架构:感知→治理→服务→应用
要建成这样扎实的数据底座,需遵循一套清晰的分层架构。这并非纸上谈兵,而是从无数次失败中总结出的实践路径。
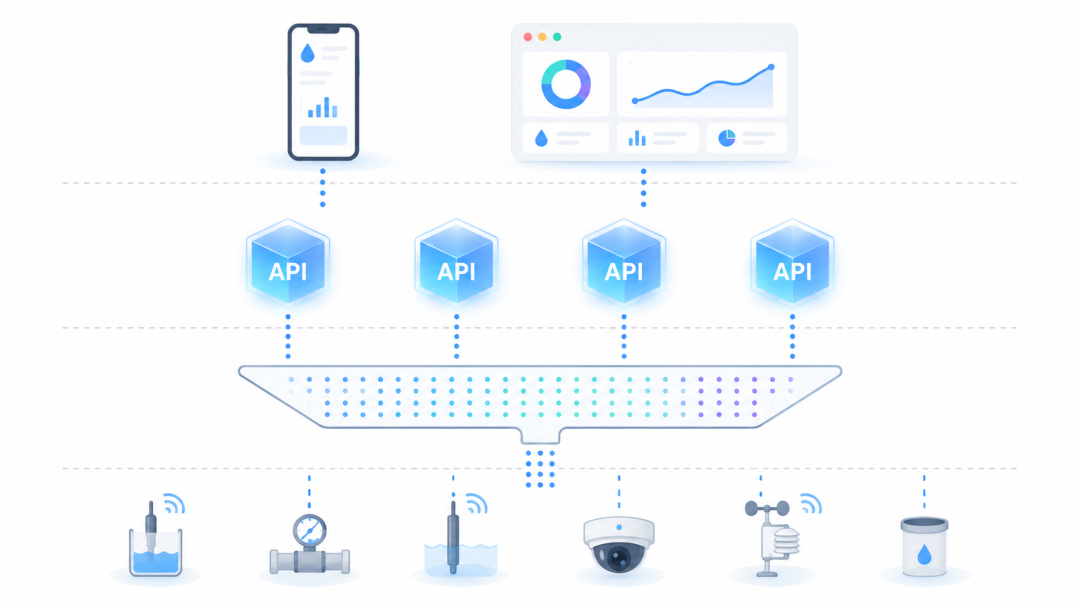
第一层:感知层——构建全域感知一张网
这一层解决数据“活起来”的问题。它不只连接传统的SCADA实时监测点,还要统一接入在线仪表、泵站PLC、水质监测站、二次供水设备、智能水表等异构数据源。技术上需要兼容OPC UA、MQTT、Modbus等多种协议,并在边缘侧做初步的清洗和缓存。
更关键的是,要把人的“感知”也纳入:巡检人员的移动终端、热线系统的来电记录、管网维修的工单信息,这些非结构化的业务数据同样是感知层的重要组成部分。没有它们,物联数据就是失去业务背景的孤数。
第二层:治理层——让数据说同一种语言
这是最考验耐心的一层,也是智慧水务成色的分水岭。治理层要把感知层汇聚的海量数据,进行标准化、清洗、关联和重组。
具体工作包括:制定并落实全公司统一的对象编码体系(例如每一段管道、每一个阀门拥有唯一且跨系统通用的ID),建立标准化的时空基准,按“水质、水量、水压、设备、用户、事件”等主题域重构数据。同时,要建立数据质量稽核规则,自动识别异常值、补全缺失、剔除跳变。至此,数据才能真正“跑起来”,一条压力波动信息,可以自动关联到网络拓扑、影响用户和相关的维修记录。
第三层:服务层——把数据变成即插即用的能力
治理好的数据不应该再以原始表的形式直接暴露给应用,而是封装成标准的数据服务。这层是数据底座与上层应用之间的“契约”。
我们将基础的查询、分析、模型运算能力,包装为统一的API或消息事件。比如“获取某个DMA分区过去24小时每15分钟的流量和压力数据”、“根据爆管点坐标返回需关闭的阀门列表及受影响用户数”、“推送全网泵站异常启停事件”。服务层的存在,解耦了数据提供方和数据消费方,让应用开发不再面对无数个烟囱数据库,而是面向一整套鲜活、可复用、权限可控的数据服务。
第四层:应用层——轻量化、场景化地释放智慧
有了坚实的前三层,智慧应用才能变得轻盈。漏损控制系统不再需要自己从SCADA和营收系统拉数据、做治理,它直接从服务层调用标准的计量分区水量、压力及用户服务接口,专注在算法模型上。应急指挥、智能调度、用户画像、水质预测等所有场景,都基于同一套服务底座构建。
这样,应用层不再臃肿庞大、重复造轮子,真正实现了“应用百花齐放,数据基础统一”。
四、数据底座与传统IT系统的本质区别
这个区别不是技术名词的差异,而是思维方式和水务运营范式的彻底转变。
从“为功能建系统”转向“为业务建数据”
传统模式是:要上一个漏控项目,就建一套包含采集、存储、展示的垂直系统,数据长在项目里。
数据底座模式是:先花大力气把全域数据底座立起来,所有业务应用都长在同一个数据根上。数据成为企业的永久资产,不再随项目结束而沉寂。
从“人找数据”转向“数据找人”
以前是业务人员需要数据了,分别登录各个系统查询、导出、手工拼接。现在,基于统一的服务层,数据可以主动推送到工作流中:管网异常会自动触发消息,附带相关压力曲线、历史维修和影响范围,直接推送到值班人员的终端上,形成闭环。
从“静态报表”转向“动态孪生”
传统IT产出的是T+1的统计报表和静态地图,数据底座支撑的是高频率、近实时的数字孪生。它不是一张图,而是一面能映射物理管网、设备、水量、水压实时状态的镜子,并支持回溯和推演。
从“点对点接口”转向“数据服务总线”
烟囱时代,每两个系统要交互就得做一对接口,N个系统就可能需要N×(N-1)个接口,系统耦合极深、维护成本极高。
数据底座提供统一的服务总线,任何系统遵循协议即可接入,极大降低了集成复杂度和长期拥有成本。
说到底,智慧水务的“地基”,不是一个数据库软件,也不是一个中台产品,更不是指挥中心那块大屏。它是让全业务链条的数据活起来、跑起来、用起来的一整套体系——这就是数据底座。
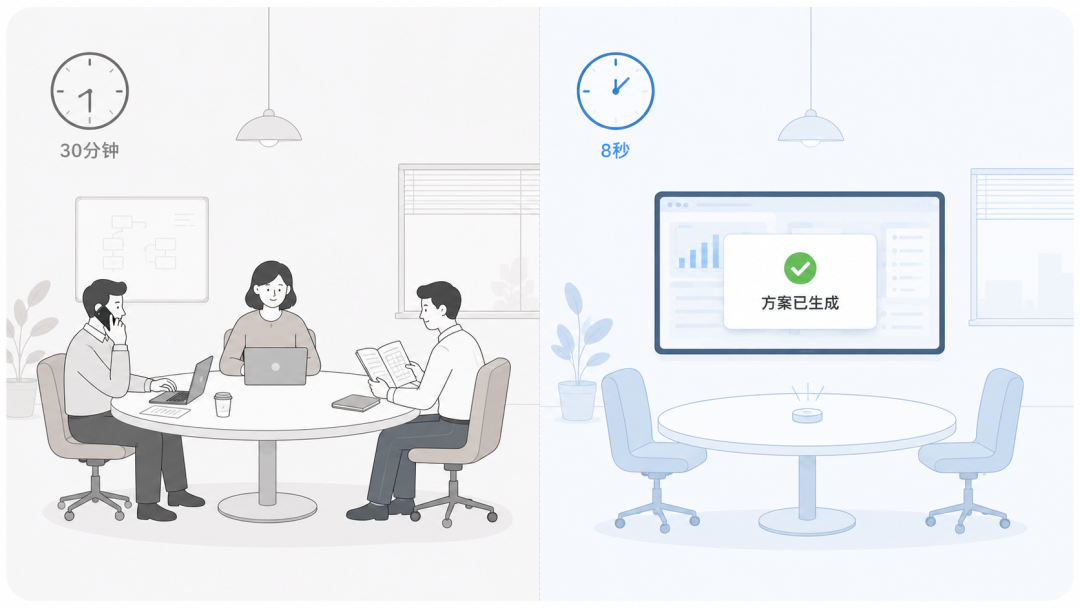
我曾在一家水司看到,当他们在一次爆管演习中,基于底座服务,仅用8秒就自动给出了关阀方案、影响用户清单和通知短信模板;而在两年前,同样的推演需要4个部门、打10多通电话、耗时近30分钟。那一刻,大家才真正相信:搞智慧水务,先把地基夯实,其它的自然会生长出来。
与其持续在烟囱的迷宫里打转,不如从今天起,追问自己一句:我们每天产生的数据,活了吗?