智慧水务正在从“信息化系统”走向“AI驱动的认知与决策系统”。
在这一转型过程中,AI产品的成功不再依赖单点算法能力,而是取决于是否形成一套可持续演进的方法论体系。
“需求识别 → 模型沉淀 → 产品迭代闭环”,本质上是将水务业务从经验驱动,升级为数据驱动,再进一步走向智能决策驱动的核心路径。
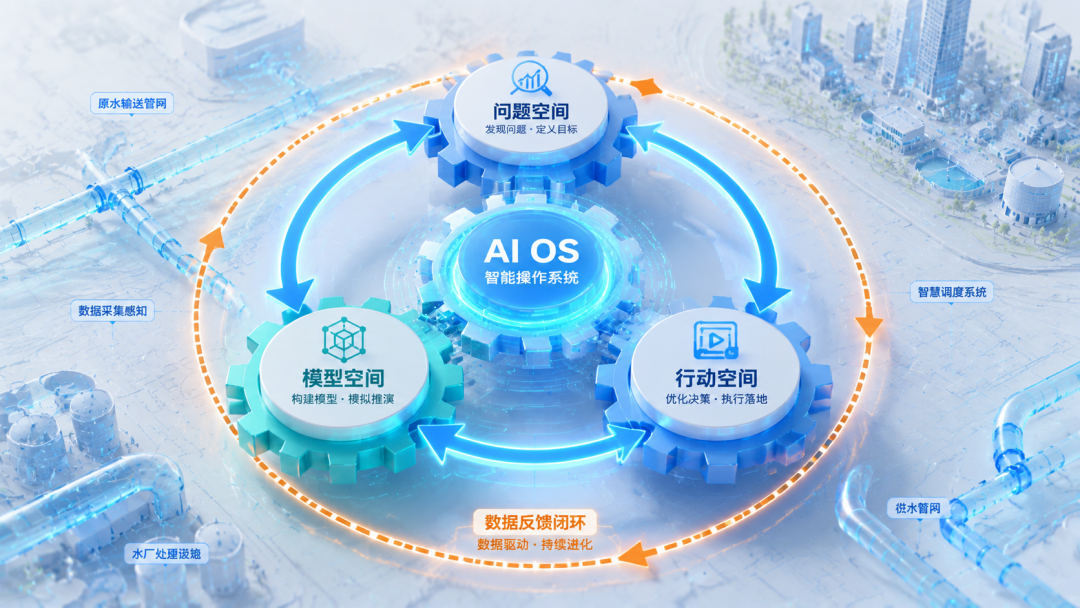
一、需求识别:从“业务问题”而非“技术问题”出发
智慧水务AI产品的起点不是模型,而是问题结构化能力。
传统水务需求往往呈现三个特征:
问题描述经验化(如“漏损偏高”“水压不稳”)
数据表达碎片化(SCADA、GIS、DMA、客服系统割裂)
目标函数模糊(“优化运行”“提升效率”缺乏量化指标)
- 需求重构的三个层级
AI产品需要将需求重构为三层结构:
(1)业务事件层
漏损发生
爆管风险
水质异常
泵站能耗升高
(2)可观测数据层
压力/流量时序
DMA分区数据
泵站工况
氯浓度/浊度
(3)决策输出层
是否预警?
是否调度?
调度到哪个阀门/泵?
优化目标(成本/安全/稳定)
👉 关键点:
AI产品不是“预测水务指标”,而是“支撑决策动作”。
- 需求优先级判断逻辑
智慧水务中,AI需求优先级通常由三个维度决定:
风险性(Risk):是否涉及供水安全
成本性(Cost):是否影响能耗/漏损
可数据化程度(Dataability):是否能稳定获取训练数据
形成一个简单筛选逻辑:
高风险 + 可数据化 = 优先AI化场景
例如:
漏损预测 ✔(高风险 + 高数据可得性)
爆管预警 ✔
客服投诉分类 ✔
管网腐蚀机理分析 ✖(数据不足)

二、模型沉淀:从“单模型能力”到“场景模型资产化”
很多智慧水务AI项目失败的关键原因,不是模型不准,而是模型无法复用与积累。
模型沉淀的核心是:
将模型从“项目交付物”变成“可持续资产”
- 模型结构的三层解耦
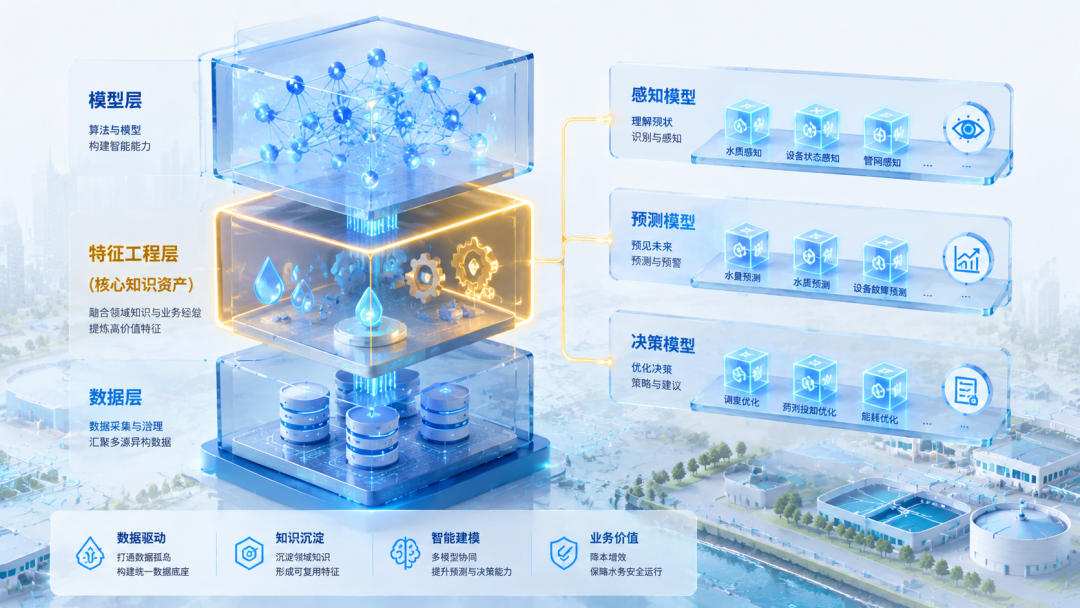
智慧水务AI模型应拆为三层结构:
(1)基础数据层
时序数据(压力/流量)
空间数据(GIS管网)
设备数据(泵/阀状态)
(2)特征工程层
DMA夜间最小流量
压力波动频率
泵启停周期
水龄模拟指标
(3)模型层
漏损检测模型(分类/异常检测)
爆管风险模型(时序预测)
能耗优化模型(强化学习/回归)
👉 核心思想:
特征层才是“水务AI真正的知识沉淀层”。
- 从“单点模型”到“模型库体系”
成熟的智慧水务AI平台,应形成三类模型库:
感知类模型(What is happening)
异常检测
状态识别
预测类模型(What will happen)
流量预测
压力预测
需求预测
决策类模型(What should we do)
泵站调度优化
阀门控制策略
漏损修复优先级排序
- 模型沉淀的关键机制
模型是否能沉淀,取决于三个机制:
数据持续回流(闭环数据)
标签不断修正(人工+自动)
模型版本管理(MLOps)
没有这三点,AI项目会退化为“一次性交付软件”。
三、产品迭代闭环:从“系统工具”到“智能体系统”
智慧水务AI产品的最终形态,不是仪表盘,而是“持续自学习系统”。
- 闭环结构设计
完整闭环应包括:
数据输入 → 模型推理 → 决策输出 → 执行反馈 → 再训练
例如漏损场景:
管网压力/流量数据进入模型
输出“疑似漏损区域”
运维人员现场核查
确认是否真实漏损
结果回流训练模型
👉 关键点:
“是否真实发生”必须回流,否则模型无法进化。
- 产品形态的三阶段演进
智慧水务AI产品通常经历三个阶段:
阶段1:看板化(Dashboard AI)
数据展示
简单预警
阶段2:辅助决策(Decision Support AI)
提供建议
人工决策为主
阶段3:自主优化(Autonomous Optimization AI)
自动调度
自适应策略优化
- 产品闭环的核心指标体系
衡量闭环是否成立,不是看模型准确率,而是看:
漏损识别 → 修复转化率
预警 → 有效命中率
决策采纳率
人工干预下降比例
单位供水能耗下降
👉 本质:
AI产品的价值 = “减少不确定性 + 提升可执行性”
四、三段式方法论的整体逻辑
可以将该方法论抽象为一个系统结构:
需求识别(Problem Space)
↓
模型沉淀(Model Space)
↓
产品闭环(Action Space)
↺(数据回流)
这是一个典型的“水务AI操作系统结构”。
五、核心总结
智慧水务AI的本质不是“做模型”,而是构建三种能力:
把业务问题结构化的能力
把经验转化为模型资产的能力
把模型结果转化为持续行动的能力
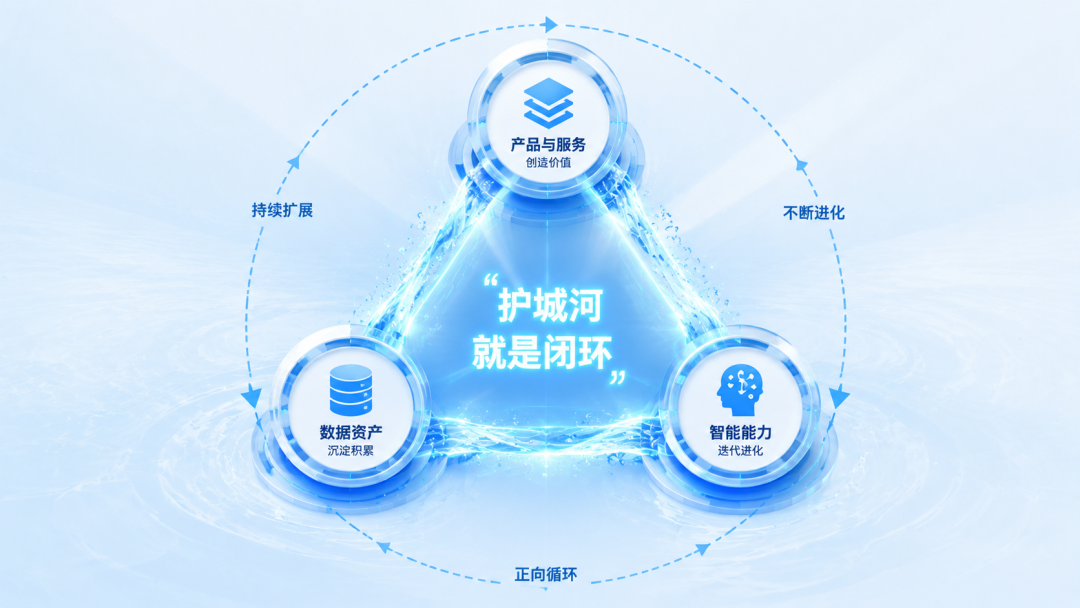
“需求识别 → 模型沉淀 → 产品迭代闭环”不是线性流程,而是一个持续自进化系统。